

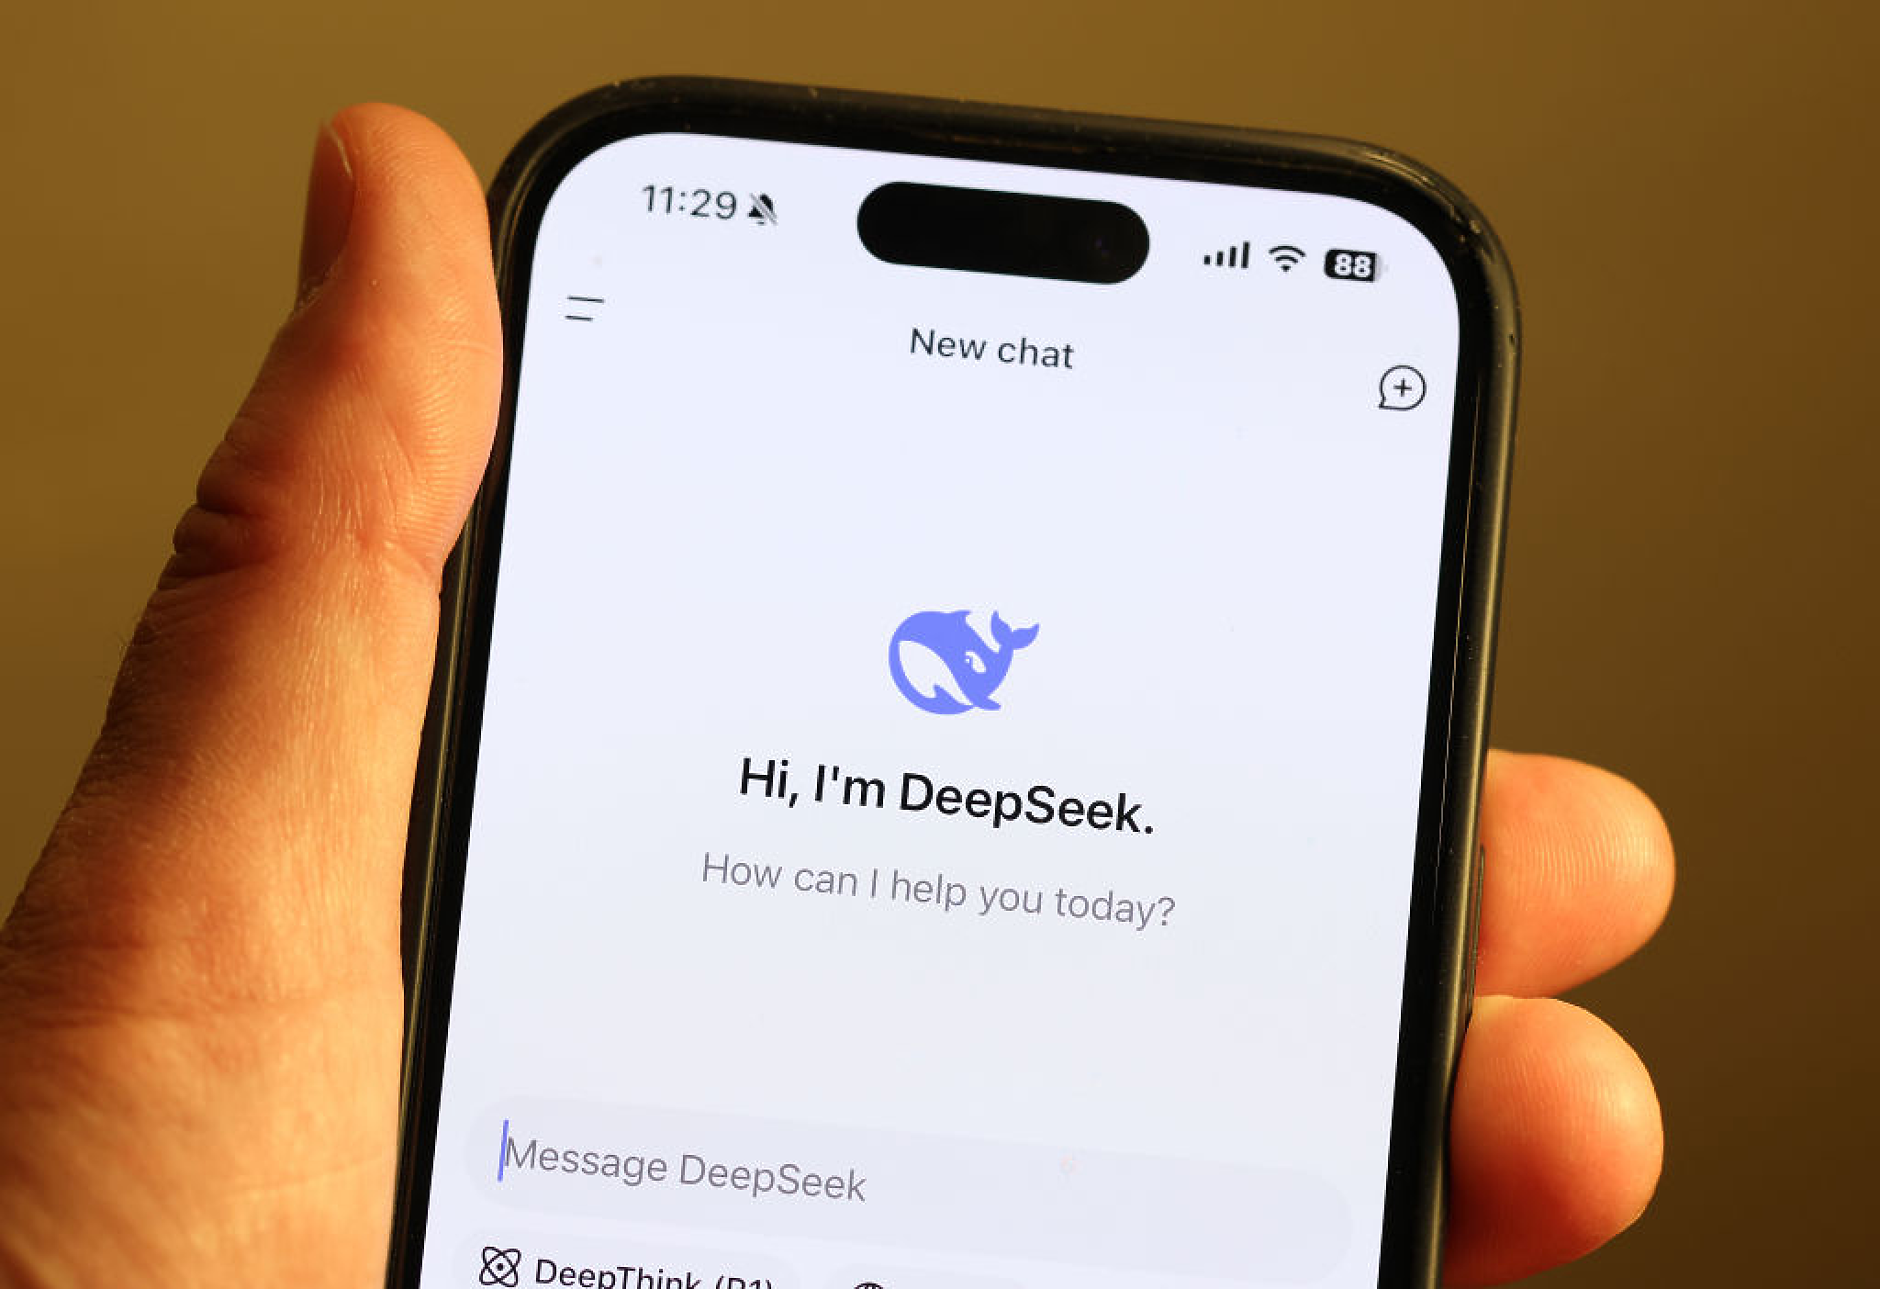
Обучението на хитовия AI модел на Deepseek е струвало само 294 хил. долара
 Обновена 09:25ч., 19.09.2025


Китайският стартъп за изкуствен интелект DeepSeek заяви, че е похарчил 294 000 долара за обучение на своя модел R1 в статия, която вероятно ще възобнови дебата за мястото на Пекин в надпреварата за разработване на изкуствен интелект, пише Ройтерс.
Рядката актуализация от базираната в Ханджоу компания - първата оценка, която е публикувала за разходите за обучение на R1, се появи в рецензирана статия в академичното списание Nature, публикувана в сряда.
Представянето на по-евтини системи с изкуствен интелект от Deepseek през януари накара глобалните инвеститори да се отдръпнат от технологични акции на фона на опасенията, че новите модели биха могли да застрашат господството на лидерите в областта на изкуствения интелект, включително Nvidia.
В статията в Nature, в която основателят на компанията Лян Уенфън е посочен като един от съавторите, се казва, че обучението на модела R1 на DeepSeek, фокусиран върху разсъжденията, е струвало 294 000 долара и е използвало 512 чипа Nvidia H800. Предишна версия на статията, публикувана през януари, не съдържаше тази информация.
Разходите за обучение на т. нар. големи езикови модели, захранващи чатботове с изкуствен интелект, се отнасят до разходите, направени от работата на клъстер от мощни чипове в продължение на седмици или месеци за обработка на огромни количества текст и код.
Сам Алтман, главен изпълнителен директор на американския гигант в областта на изкуствения интелект OpenAI, заяви през 2023 г., че обучението на фундаменталните модели е струвало „много повече“ от 100 милиона долара, въпреки че компанията му не е предоставила подробни данни за нито един от AI моделите си.
Някои от твърденията на DeepSeek относно разходите за разработка и използваната технология бяха поставени под въпрос от американски компании и длъжностни лица.
Споменатите чипове H800 са проектирани от Nvidia за китайския пазар, след като през октомври 2022 г. САЩ забраниха на компанията да изнася по-мощните AI чипове H100 и A100 за Китай.
През юни американски служители заявиха пред Ройтерс, че DeepSeek има достъп до „големи обеми“ чипове H100, които са били закупени след въвеждането на контрол върху износа от САЩ. По това време Nvidia заяви пред Ройтерс, че DeepSeek е използвала законно придобити чипове H800, а не H100.
В допълнителен информационен документ, придружаващ статията в Nature, компанията за първи път призна, че притежава чипове A100 и заяви, че ги е използвала в подготвителните етапи на разработка.
„Що се отнася до нашите изследвания върху DeepSeek-R1, използвахме графичните процесори A100, за да се подготвим за експериментите с по-малък модел“, посочват изследователите. След тази начална фаза R1 е бил обучен общо 80 часа на клъстер от 512 чипа H800, добавят те.
Ройтерс вече съобщи, че една от причините DeepSeek да е успяла да привлече някои от най-блестящите умове в Китай е, че е била една от малкото местни компании, които управляват клъстер от суперкомпютри A100.
DeepSeek също така отговори за първи път, макар и не директно, на твърденията на висш съветник на Белия дом и други фигури в областта на изкуствения интелект в САЩ през януари, че умишлено е „дестилирала“ моделите на OpenAI в свои собствени.
DeepSeek последователно защитава дестилацията като водеща до по-добра производителност на моделите, като същевременно е много по-евтина за обучение и експлоатация, което позволява по-широк достъп до технологии, задвижвани от изкуствен интелект, поради енергоемките изисквания на тези модели за ресурси.
Терминът се отнася до техника, при която една система с изкуствен интелект се учи от друга система с изкуствен интелект, позволявайки на по-новия модел да се възползва от инвестициите във време и изчислителна мощност, вложени в изграждането на по-ранния модел, но без свързаните с това разходи.
DeepSeek заяви през януари, че е използвала модела с отворен код Llama AI на Meta за някои дестилирани версии на собствените си модели.
В статията Nature DeepSeek посочва, че данните за обучението на техния V3 модел разчитат на обходени уеб страници, които съдържат „значителен брой генерирани от модела на OpenAI отговори, което може да накара базовия модел да придобие знания от други мощни модели индиректно“.
Но от компанията отбелязаха, че това не е умишлено, а по-скоро случайно.
НОВ КОМЕНТАР
ОЩЕ ОТ КАТЕГОРИЯТА
|
|
Надпревара с времето на COP31: Близо 200 държави в безизходица заради спора за изкопаемите горива
Свят | Обновена 10:04ч., 21.11.2026
Дневник за родители: Спират ли да „работят“ антибиотиците?
Наука и Здраве |
Обновена 09:50ч., 21.11.2026
Зеленски отговори на Тръмп: За нас Путин е враг и убиец
Свят |
Обновена 09:15ч., 21.11.2026
Времето през уикенда: Облачно с превалявания
Общество |
Обновена 07:30ч., 21.11.2026
St. Andrew’s Black Tie Ball 2026: една вечер, която дава повече възможности
ПР и събития |
Обновена 12:30ч., 19.11.2026
Crowne Plaza® Sofia – стандарт за гостоприемство и събития от следващо поколение
ПР и събития |
Обновена 16:40ч., 20.11.2026
Хакери източиха и публикуваха данни на 16 000 клиенти на Visa, Mastercard и JPMorgan
Технологии |
Обновена 11:50ч., 20.11.2026
Chevron започва морски проучвания за нефт и газ в Гърция
Компании |
Обновена 17:00ч., 20.11.2026
Южна Корея стана четвъртата страна в света с износ за над 1 трлн. долара
Икономика |
Обновена 18:15ч., 19.11.2026
Чертата, която лидерите погрешно смятат за слабост
Лидерство |
Обновена 00:48ч., 21.11.2026
Защо малкият бизнес трябва да започне да функционира като местна медия?
Маркетинг |
Обновена 01:40ч., 21.11.2026
Берлин оттегли съпротивата си срещу придобиването на Commerzbank от UniCredit
Компании |
Обновена 10:00ч., 19.11.2026
Ройтерс: ЕЦБ ще обсъди повишаване на изискванията за задължителни резерви следващата седмица
Икономика |
Обновена 18:30ч., 19.11.2026

Коментари
Няма въведени кометари.